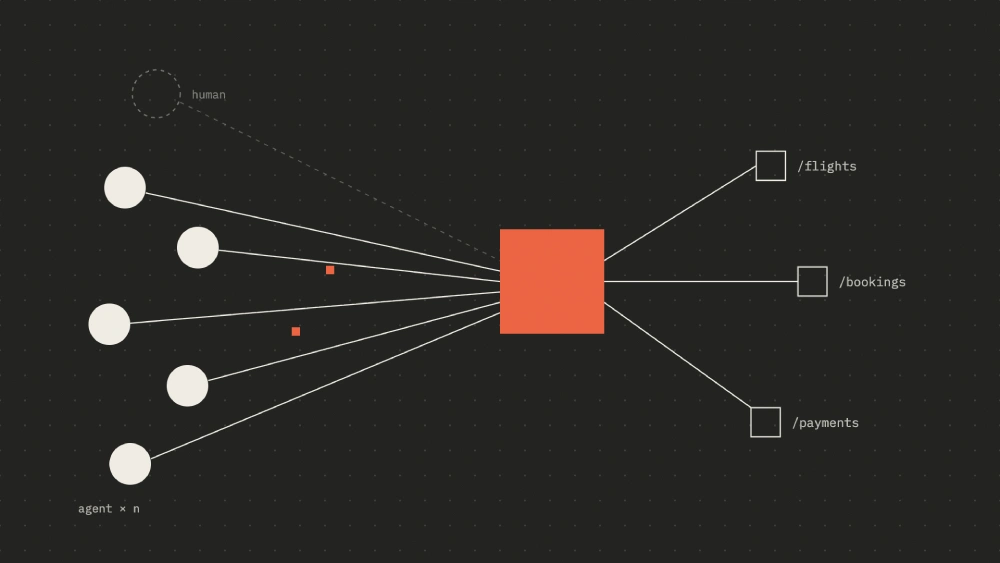
تا همین دو سال پیش، وقتی درباره طراحی API صحبت میکردیم، فرض پنهان این بود که طرف مقابل یک انسان است؛ کسی که صفحهای را در مرورگر باز میکند، روی دکمهای کلیک میکند و اگر چیزی اشتباه پیش رفت، خودش تصمیم میگیرد چه کار کند. اما امروز، بخش بزرگی از ترافیک API را سیستمهای خودکار تشکیل میدهند — agentهایی که کد تولید میکنند، pipelineها را اجرا میکنند و بدون دخالت انسان با backend شما صحبت میکنند.
این یعنی یک تغییر بنیادی در نحوه طراحی API. فرض کنید agent شما در حال اجرای یک درخواست POST است و وسط کار timeout میخورد. چه میکند؟ retry میکند. اما اگر endpoint شما idempotent نباشد، این retry ممکن است باعث ایجاد داده تکراری بشود. این فقط یکی از دهها سناریویی است که طراحی سنتی API برای آن آماده نیست.
در این مقاله، سه اصل کلیدی طراحی API برای AI Agentها را بررسی میکنیم که هر مهندس بکاند باید بداند.
فهرست مطالب
- Idempotency Key در تمام عملیات نوشتنی
- OpenAPI Schema سختگیرانه
- خطاهای Machine-Readable
- چکلیست عملی
- پرسشهای متداول
۱. Idempotency Key در تمام عملیات نوشتنی
Idempotency Key یک شناسه یکتاست که client در هر درخواست ارسال میکند. اگر همان درخواست بهدلیل timeout، قطعی شبکه یا رفتار retry خودکار agent دوباره ارسال شود، سرور تشخیص میدهد که این درخواست قبلاً پردازش شده و نتیجه قبلی را برمیگرداند، بهجای اینکه داده تکراری ایجاد کند.
چرا این موضوع برای AI Agentها حیاتی است؟ چون agentها برخلاف انسان، صبر نمیکنند تا ببینند چه اتفاقی میافتد. اگر timeout بگیرند، بهطور خودکار retry میکنند — گاهی چندین بار پشتسرهم. بدون idempotency key، هر retry میتواند یک سفارش جدید، یک پرداخت تکراری یا یک رکورد اضافی در دیتابیس ایجاد کند.
پیادهسازی ساده است: یک فیلد idempotency-key در header میگیرید، آن را در Redis یا دیتابیس ذخیره میکنید و قبل از پردازش درخواست، چک میکنید که آیا قبلاً با همین key پردازش شده یا نه. در TypeScript با Node.js، این کار با یک middleware ساده قابل انجام است؛ در Python با FastAPI نیز با یک decorator قابل پیادهسازی است.
POST /api/orders
Idempotency-Key: 8f3a2b1c-4d5e-6f7a-8b9c-0d1e2f3a4b5c
Content-Type: application/json

{
  "product_id": "prod_123",
  "quantity": 2
}
اگر همین درخواست با همان Idempotency-Key دوباره ارسال شود، سرور باید نسخه قبلی را برمیگرداند، نه یک سفارش جدید ایجاد کند.
۲. OpenAPI Schema سختگیرانه
وقتی یک انسان از API استفاده میکند، میتواند به مستندات نگاه کند، نوع فیلدها را حدس بزند و اگر چیزی اشتباه پیش رفت، خودش اصلاح کند. اما AI Agent این luxury را ندارد. agent بر اساس schemaای که از API دریافت میکند، درخواست خود را میسازد. اگر schema مبهم باشد، agent میتواند هر چیزی ارسال کند.
مشکل رایج این است: بسیاری از APIها در پاسخ یا درخواست خود از نوع object استفاده میکنند — یعنی هر کلید و مقداری قابل قبول است. این برای انسان شاید قابل قبول باشد، اما برای agent یعنی هیچ تضمینی وجود ندارد که چه چیزی ارسال شود یا دریافت کند.
راهحل این است: هر endpoint باید یک OpenAPI schema دقیق داشته باشد که نوع هر فیلد، required یا optional بودن، محدودیتها و فرمت را مشخص کند. بهجای object with any keys، باید بگویید OrderCreateRequest با فیلدهای مشخص product_id: string، quantity: integer, minimum: 1 و غیره.
این کار نهتنها به agent کمک میکند درست درخواست بسازد، بلکه اگر چیزی اشتباه بود، خطای دقیقی دریافت میکند که میتواند آن را مدیریت کند — نه یک پیام مبهم 400 Bad Request.
۳. خطاهای Machine-Readable
بزرگترین تفاوت طراحی API برای انسان و AI در نحوه مدیریت خطاست. وقتی یک انسان خطای "عملیات ناموفق بود" دریافت میکند، میتواند context را بفهمد و تصمیم بگیرد. اما AI Agent با این پیام هیچ کاری نمیتواند انجام دهد.
بهجای پیام متنی انسانی، خطاها باید ساختاریافته و machine-readable باشند. یک پاسخ خطای استاندارد باید شامل این فیلدها باشد:
{
  "error_code": "RATE_LIMIT_EXCEEDED",
  "message": "Rate limit exceeded. Please retry after the specified delay.",
  "retry_after_seconds": 30,
  "request_id": "req_abc123"
}
error_code یک شناسه ثابت و قابل برنامهریزی است که agent میتواند بر اساس آن منطق retry یا fallback بنویسد. retry_after_seconds به agent میگوید دقیقاً چقدر صبر کند. request_id برای debug و tracking مفید است. این ساختار به agent اجازه میدهد خطا را بدون نیاز به دخالت انسان مدیریت کند.
قاعده کلی این است: هر خطایی که ممکن است agent دریافت کند، باید به گونهای طراحی شود که یک برنامه بتواند بر اساس آن تصمیم بگیرد — retry کند، صبر کند، مسیر دیگری را امتحان کند یا به کاربر اطلاع دهد.
چکلیست عملی طراحی API برای AI Agent
اگر در حال طراحی API هستید که قرار است AI Agentها از آن استفاده کنند، این چکلیست را در نظر بگیرید:
- Idempotency Key در تمام عملیات POST، PUT و PATCH
- OpenAPI schema دقیق برای تمام endpointها — بدون فیلد
objectمبهم - Structured errors با
error_code،retry_after_secondsوrequest_id - Rate limiting شفاف با headerهای
X-RateLimit-RemainingوX-RateLimit-Reset - Pagination با cursor-based بهجای offset-based (برای مجموعه دادههای بزرگ)
- Versioning صریح در URL (
/v1/) تا تغییرات API agentها را نشکنند - Webhook برای عملیاتهای طولانی — agent بتواند بهجای polling منتظر نتیجه بماند
- Health check endpoint در
/healthبرای پایش خودکار
این موارد در هر تکنولوژیای قابل پیادهسازی هستند — چه TypeScript با Node.js، چه Python با FastAPI و چه Go. مهم درک اصل طراحی است، نه ابزار خاص.
پرسشهای متداول
طراحی API برای AI Agentها چه تفاوتی با طراحی API معمول دارد؟
در طراحی API برای AI Agentها، فرض بر این است که caller یک برنامه خودکار است که ممکن است retry کند، timeout بخورد یا رفتار غیرقطعی داشته باشد. به همین دلیل باید idempotency key در تمام عملیات نوشتنی استفاده شود، OpenAPI schema سختگیرانه باشد و خطاها machine-readable باشند نه صرفاً پیام متنی.
Idempotency Key چیست و چرا برای AI Agentها مهم است؟
Idempotency Key یک شناسه یکتاست که client در هر درخواست ارسال میکند. اگر همان درخواست بهدلیل timeout یا retry دوباره ارسال شود، سرور نتیجه قبلی را برمیگرداند، بهجای اینکه داده تکراری ایجاد کند. این برای AI Agentها حیاتی است چون آنها در صورت timeout بهطور خودکار retry میکنند.
چگونه خطاهای API را machine-readable کنیم؟
بهجای پیام خطای انسانی، از ساختار JSON با فیلدهای error_code، retry_after_seconds و request_id استفاده کنید. این ساختار به AI Agent اجازه میدهد بدون دخالت انسان، خطا را مدیریت کند.
آیا برای طراحی AI-oriented API به تکنولوژی خاصی نیاز داریم؟
تکنولوژی خاصی نیاز نیست. مفاهیمی مثل idempotency key، OpenAPI schema و structured error handling در هر framework قابل پیادهسازی است — چه TypeScript با Node.js، چه Python با FastAPI و چه Go. مهم درک اصول طراحی است نه ابزار خاص.
BLUF در طراحی API یعنی چه؟
BLUF مخفف Bottom Line Up Front است. در طراحی API برای AI، یعنی پاسخ API باید مستقیماً و بدون نیاز به پردازش اضافی، اطلاعات کلیدی را در ابتدای response قرار دهد تا Agent بتواند بدون نیاز به چندین درخواست، اطلاعات لازم را دریافت کند.
نویسنده: Amirhossein Janmohammadi— Senior Software Engineer متخصص در طراحی معماری نرمافزار، توسعه بکاند و طراحی API. بیشتر درباره من: LinkedIn
لینک مقالات مرتبط:
معماری بکاند برای اپلیکیشنهای LLM
از میکروسرویس به Modular Monolith
برای مشاوره فنی یا همکاری در پروژههای نرمافزاری، از طریق صفحه تماس در ارتباط باشید.